Technique
Prompt
Instruction envoyée à un modèle d'IA, avec le contexte nécessaire. Sa longueur influe directement sur le coût, et sa qualité sur la pertinence de la réponse.
En pratique
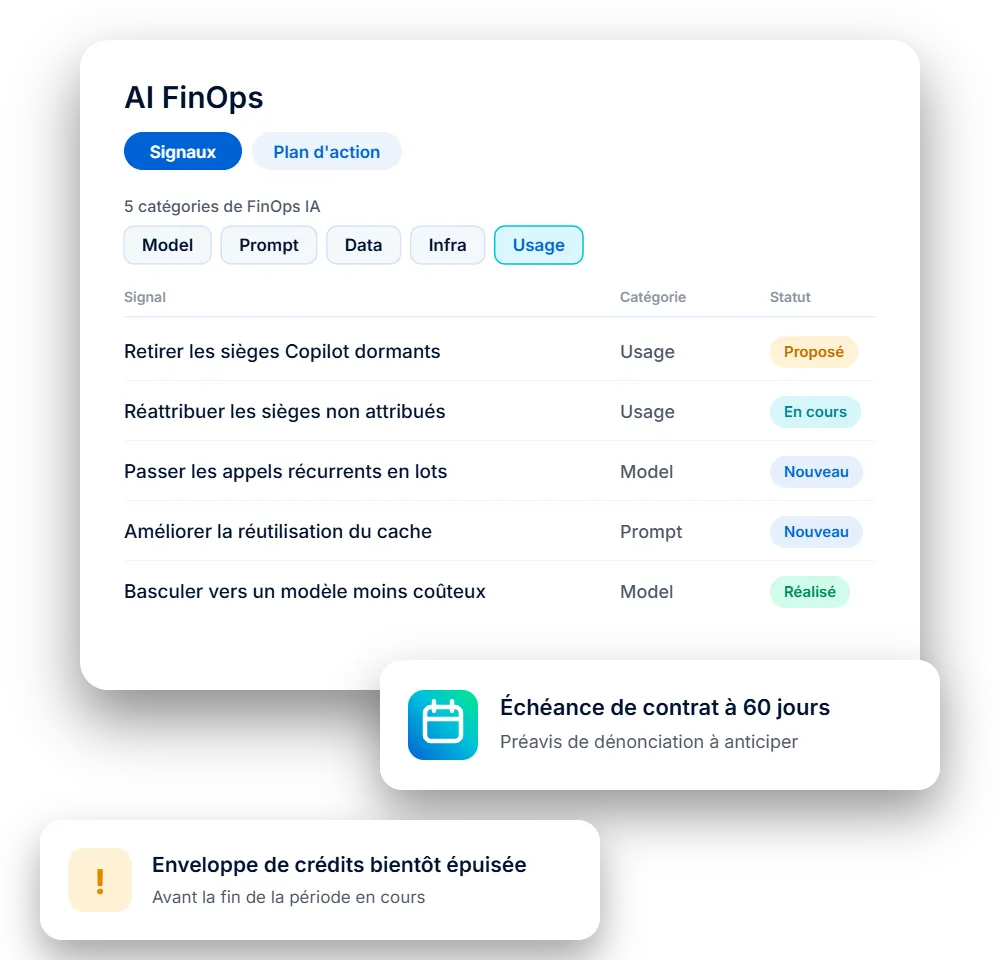
Un prompt qui répète à chaque appel plusieurs pages d'instructions coûte cher sur des milliers de requêtes. Raccourcir les consignes, structurer la demande et mettre en cache la partie fixe réduisent la facture.
Termes liés
Maîtrisez vos dépenses IA et pilotez votre ROI.
Commençons par un diagnostic de vos usages et de vos coûts.
SOPTIMA aide les PME et ETI à maîtriser leurs dépenses, leurs usages et la gouvernance de leur intelligence artificielle.