FinOps IA : cinq leviers pour réduire la facture sans dégrader les résultats

En bref
- Le FinOps appliqué à l'IA consiste à maîtriser les dépenses d'IA sans dégrader la qualité des résultats.
- Cinq leviers structurent la démarche : le choix du modèle, l'optimisation des prompts, la rationalisation des usages, l'infrastructure et la sélection des données envoyées aux modèles.
- Les gains peuvent être importants : 50 % sur les traitements non urgents, au moins 90 % sur les instructions relues depuis un cache, et un prix qui peut varier de 1 à 40 entre deux modèles d'un même éditeur.
- Le préalable reste la visibilité : on n'optimise pas ce que l'on ne mesure pas.
Qu'est-ce que le FinOps appliqué à l'IA ?
Le FinOps est une discipline née avec le cloud : elle réunit finance, technique et métiers pour que chaque euro dépensé produise de la valeur. Appliquée à l'IA, elle répond à un problème nouveau : des dépenses qui croissent vite, se dispersent entre de nombreux outils et varient avec l'usage.
Le sujet est devenu prioritaire. Selon l'enquête State of FinOps 2026 de la FinOps Foundation, menée auprès de 1 192 professionnels, 98 % d'entre eux gèrent désormais des dépenses d'IA, contre 31 % deux ans plus tôt. Le FinOps pour l'IA y apparaît comme la première priorité des équipes pour les années à venir.
Levier 1 : choisir le bon modèle pour chaque tâche
C'est souvent le levier le plus rapide. Tous les usages n'ont pas besoin du modèle le plus puissant. Classer des e-mails, extraire des données d'une facture ou reformuler un texte court peut être confié à un modèle léger. Les modèles haut de gamme sont à réserver aux tâches de raisonnement complexe.
Les écarts de prix sont considérables. Chez Anthropic, en octobre 2026, le million de tokens d'entrée coûte 0,10 dollar avec Claude Haiku 5.5 et 4 dollars avec Claude Opus 5.5, soit un rapport de 1 à 40 au sein de la même génération de modèles.
En pratique : lister les cas d'usage, tester un modèle plus léger sur chacun, et ne garder le modèle haut de gamme que là où la différence de qualité est réelle.
Levier 2 : optimiser les prompts et les traitements
La façon d'interroger un modèle pèse directement sur la facture.
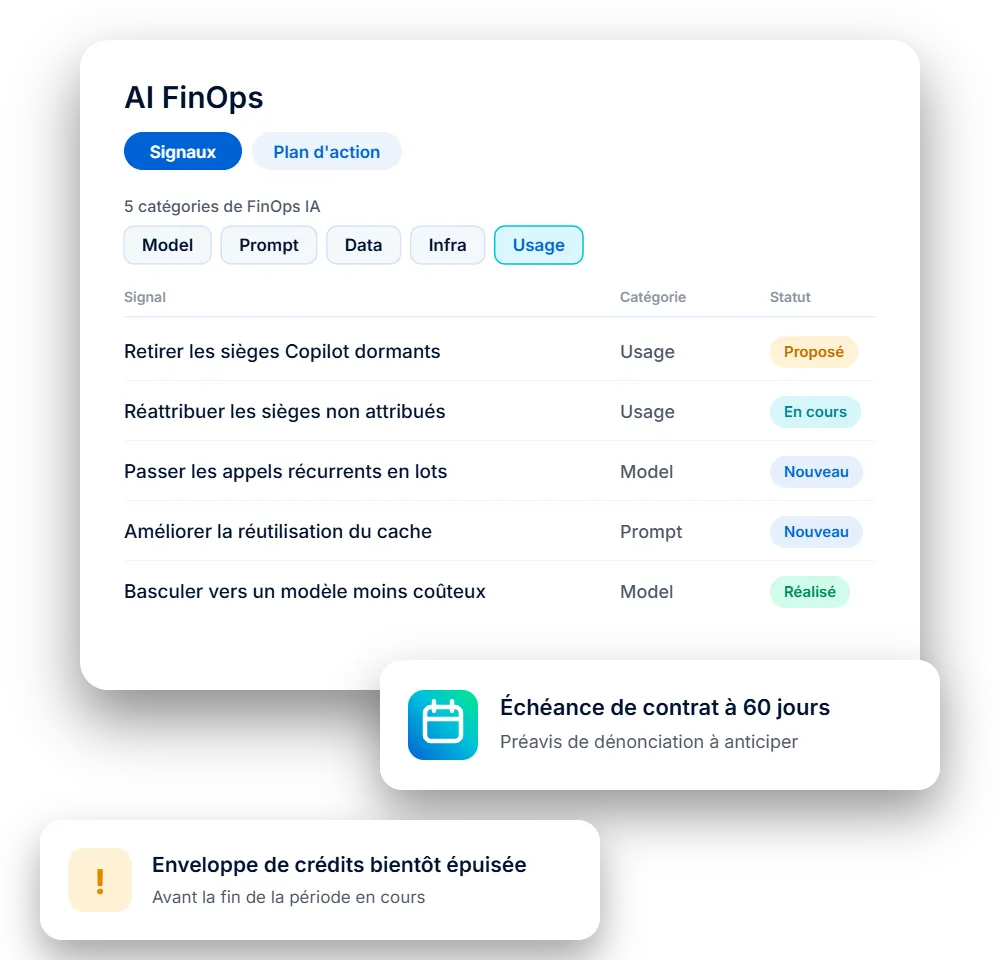
- Le traitement par lots. Les traitements non urgents (analyse de documents la nuit, classement de tickets, enrichissement de données) peuvent être regroupés. Chez OpenAI, la Batch API coûte 50 % moins cher que le traitement immédiat, avec un résultat livré sous 24 heures.
- La mise en cache. Quand les mêmes instructions ou le même document sont envoyés à chaque requête, ils peuvent être mis en cache. Chez Anthropic, les tokens relus depuis le cache sont facturés au plus 10 % du prix normal des tokens d'entrée.
- La longueur des réponses. Les tokens produits par le modèle coûtent plus cher que ceux qui lui sont envoyés : chez Anthropic, cinq fois plus. Demander des réponses courtes et structurées réduit directement la facture.
Levier 3 : rationaliser les usages
C'est là que se trouvent les économies les plus visibles, et souvent les plus rapides côté abonnements.
- Les licences peu utilisées : réattribuer ou résilier les licences dont les titulaires ne se servent pas.
- Les doublons : plusieurs assistants généralistes payés pour les mêmes personnes.
- Les agents et automatisations qui tournent sans surveillance et consomment des crédits ou des tokens sans que personne ne vérifie leur utilité.
- Le Shadow AI : les abonnements payés hors du circuit achats, qui échappent à toute négociation.
Levier 4 : ajuster l'infrastructure
Pour les projets à fort volume, les choix techniques ont un impact direct : hébergement du modèle, région de déploiement, capacité réservée ou paiement à l'usage. Réserver une capacité de calcul fait baisser le coût unitaire, mais n'est rentable que si le volume est élevé et régulier. À l'inverse, une capacité réservée mal dimensionnée devient une dépense fixe sans contrepartie.
Pour la plupart des PME, ce levier vient après les trois premiers.
Levier 5 : mieux sélectionner les données envoyées
Beaucoup d'applications d'IA d'entreprise reposent sur le RAG (génération augmentée par récupération) : le système va chercher des documents internes et les transmet au modèle avec la question. S'il est mal réglé, il envoie trop de contenu inutile, et chaque page superflue est facturée.
Mieux découper les documents, limiter le nombre d'extraits transmis et filtrer les sources réduit le coût, et améliore souvent la qualité des réponses, le modèle étant moins noyé dans du contexte hors sujet.
Par où commencer ?
Par la visibilité. Avant d'optimiser, il faut savoir combien l'entreprise dépense, où et pour quel usage.
- Consolider toutes les dépenses d'IA : abonnements, API, cloud, notes de frais.
- Rattacher chaque dépense à un service, un projet ou un usage.
- Prioriser les leviers selon le gain attendu et l'effort nécessaire : les licences inutilisées et le choix du modèle arrivent généralement en tête.
- Suivre dans la durée, avec des indicateurs simples comme le coût par utilisateur actif ou le coût par usage.
Questions fréquentes
Le FinOps IA est-il réservé aux grandes entreprises ?
Non. Une PME a moins de volume, mais aussi moins de visibilité sur ses dépenses. Les premiers leviers, comme les licences inutilisées, les doublons ou le choix du modèle, ne demandent ni outil complexe ni équipe dédiée.
Réduire les coûts dégrade-t-il la qualité ?
Pas si la démarche est bien menée. Chaque changement de modèle ou de paramétrage se teste sur des cas réels avant d'être généralisé. Certains leviers, comme le tri des données envoyées, améliorent même la qualité.
Qui doit piloter les dépenses d'IA ?
Idéalement un binôme entre la finance, qui suit les budgets, et la DSI ou un référent IA, qui connaît les usages. L'essentiel est qu'un responsable soit clairement désigné.
Pour aller plus loin
SOPTIMA accompagne les PME et ETI dans l'optimisation de leurs dépenses IA et propose une plateforme de suivi des coûts, contrats et usages. À lire aussi : Tokens, sièges, crédits : comprendre comment l'IA se facture et Licences IA en double : comment repérer et supprimer les doublons.
Sources
- FinOps Foundation, State of FinOps 2026, février 2026 (1 192 répondants).
- OpenAI, Batch API, documentation.
- Anthropic, Prompt caching et tarifs des modèles, documentation consultée en octobre 2026.
Découvrir aussi nos ressources
Maîtrisez vos dépenses IA et pilotez votre ROI.
SOPTIMA aide les PME et ETI à maîtriser leurs dépenses, leurs usages et la gouvernance de leur intelligence artificielle.